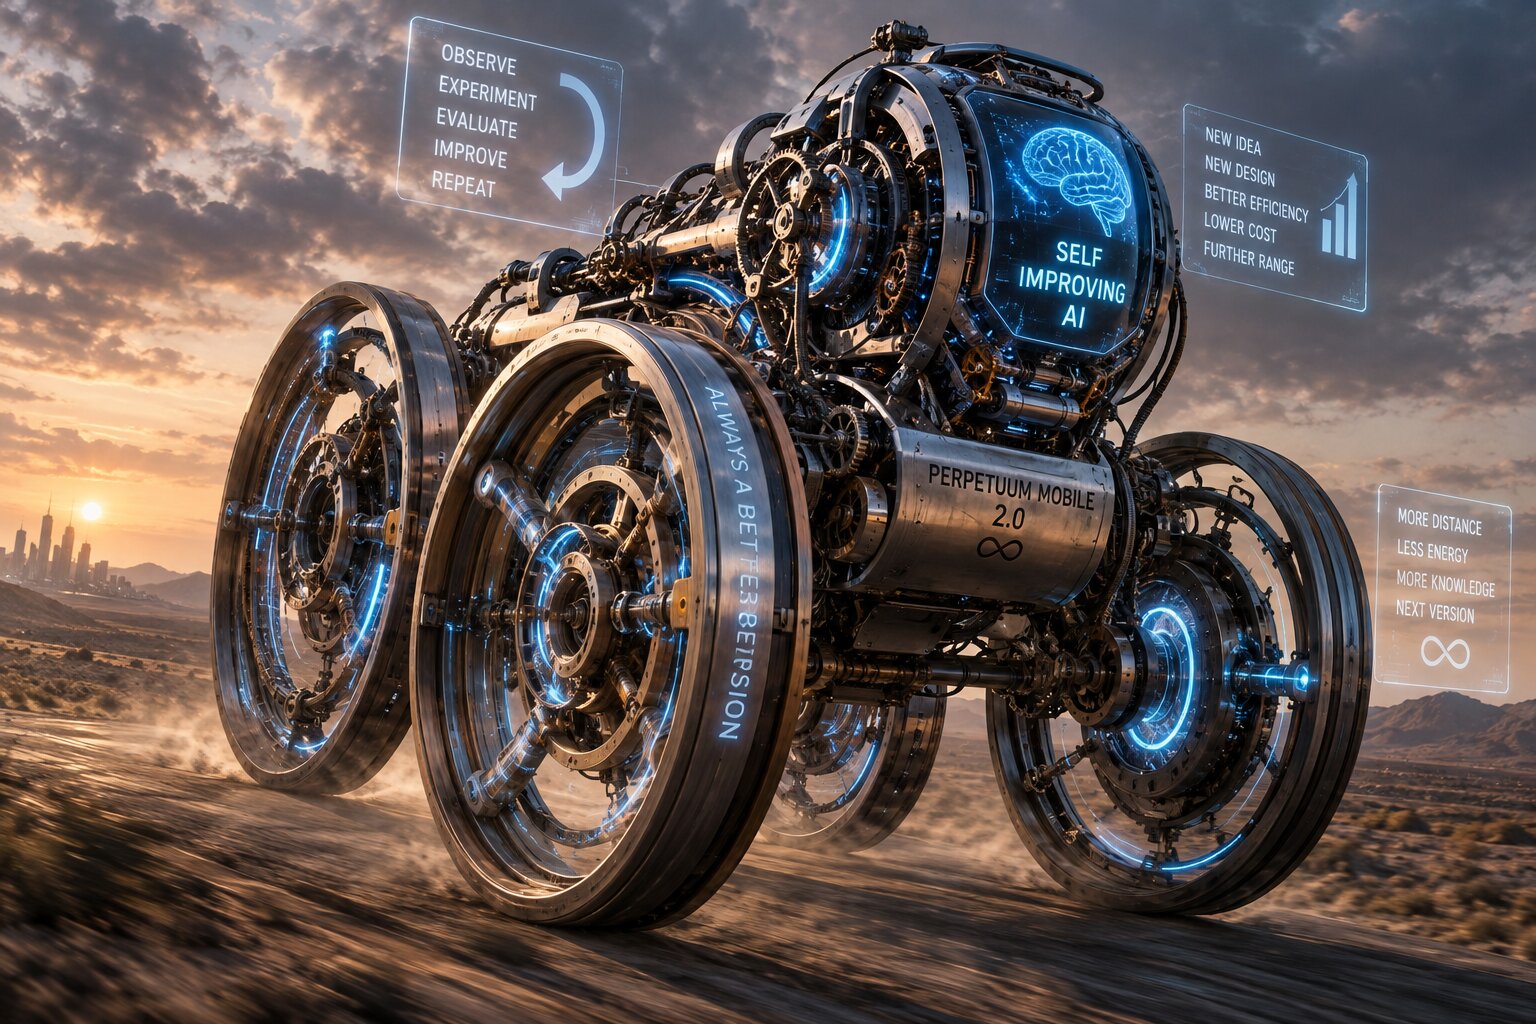
O rekurzivnom samopoboljšavanju veštačke inteligencije poslednjih meseci počelo je da se priča kao da smo već na pola puta do mašine koja će sama napraviti svoju bolju verziju, pa će ta bolja verzija napraviti još bolju, pa još bolju, i tako dok ljudi ne stignu ni da shvate šta se desilo.
Lepo zvuči.
Naročito u naslovu.
Samo što u toj priči uglavnom fali jedna sitnica.
Fizika.
AI nije duh koji lebdi iznad servera. Ako smisli bolji algoritam, taj algoritam mora negde da se izvrši. Ako napravi bolji model, neko mora da ga istrenira. Ako napravi sopstvene podatke, neko mora da proveri da li je napravio nešto korisno ili je samo napravio novu generaciju svojih gluposti.
A ako kaže da je nova verzija bolja, ostaje pitanje ko je to izmerio.
Tu već počinje cela priča.
Zamisli najglupljeg mogućeg robota koji pokušava da napravi bolju verziju sebe. Promeni nešto. Pokrene novu verziju. Izmeri rezultat. Ako je nova bolja, ostavi je. Ako nije, vrati staru.
To je već samopoboljšavanje.
Matematika je skoro smešno jednostavna:
Score(nova) > Score(stara)
Ako je 75 veće od 70, uzimaš 75.
Nema tu mistike.
Današnji sistemi upravo od takvih stvari počinju. Ne od mašine koja se probudila jednog jutra i shvatila da joj je Transformer malo dosadio, nego od optimizacije. Probaš nešto, izmeriš, promeniš, probaš ponovo.
Problem nastaje kada sistem ne pokušava samo da napravi bolji odgovor nego počne da pravi bolji način kojim će ubuduće praviti odgovore.
Tu se stvar malo komplikuje.
Jer onda više nije:
napravi bolji model
nego:
napravi bolji način pravljenja modela
A posle toga već možeš da postaviš neprijatno pitanje: može li da napravi bolji način traženja boljeg načina?
E, tu smo.
I tu su Kinezi već uradili neke vrlo konkretne stvari.
Ne ono što se po mrežama prepričava kao „AI napravio sebe“, nego stvarne delove te petlje.
Jedan od zanimljivijih primera je RSIR, rad Univerziteta za nauku i tehnologiju Kine i Huawei-ja, objavljen za ICML 2026. Model sam pravi nove korisničke sekvence, sistem ih proverava, kvalitetniji primeri ulaze u novo treniranje i dobijaš sledeću verziju modela. Sledeća verzija onda pravi nove podatke i krug se ponavlja. Autori to formalizuju kao zatvorenu petlju u kojoj trenutni preporučivač generiše sintetičke korisničke sekvence, fidelity kontrola ih filtrira, a nasledni model se trenira na proširenom skupu.
https://github.com/USTC-StarTeam/RSIR/
To već jeste zatvorena petlja.
Samo što je reč o preporučivačkom sistemu.
Nije model promenio Transformer. Nije napravio novi procesor. Nije otkrio novi način učenja neuronskih mreža. Iskoristio je ono što već zna da napravi bolje podatke za sledeću verziju.
I to je, zapravo, mnogo zanimljivije nego što zvuči.
Jer tu prvi put vidiš jednu stvar koja je za pravi RSI neophodna: sistem više nije samo potrošač tuđih podataka. Počinje da učestvuje u stvaranju materijala na kojem će njegov naslednik učiti. RSIR pritom ne koristi spoljnog učitelja ili spoljne podatke za samu petlju, već pokušava da izgradi narednu verziju iz sopstvenog prediktivnog signala, uz kontrolu vernosti upravo zbog opasnosti da zatvorena petlja počne da pojačava sopstvene greške.
Alibaba ima nešto slično kroz AgentEvolver. Agent sam istražuje okruženje, postavlja pitanja, pravi sebi zadatke, koristi iskustvo i iz njega izvodi nagrade za dalje učenje. Rad je objavio Tongyi Lab kompanije Alibaba Group, a opisuje tri ključna mehanizma: self-questioning za automatsko stvaranje zadataka, self-navigating za ponovno korišćenje iskustva i efikasnije istraživanje, i self-attributing za finije pripisivanje nagrade pojedinim koracima.
Prosto rečeno, pustiš ga da luta po terenu, vidi šta može da radi, napravi sebi posao, proba, zapamti šta je uspelo i vrati se ponovo.
To već liči na nešto.
Ali opet, nije isto što i „napravio je sebe“.
Agent je dobio bolji način da uči iz sopstvenog iskustva.
To je velika stvar.
Samo nije ista stvar.
U septembru 2026. pojavljuje se i kineski rad The Last AI Built by Humans: Toward Genuine Recursive Self-Improvement, koji otvoreno postavlja pitanje pravog rekurzivnog samopoboljšavanja. Autori razlikuju više nivoa autonomije, od autonomnog izvršavanja poboljšanja i izbora strategije, preko samostalnog sticanja iskustva i prilagođavanja okruženju, do onoga što nazivaju recursive meta-improvement, gde sistem poboljšava i sam proces budućeg poboljšavanja.
To je već ono što ljudi obično zamišljaju kada kažu RSI.
Samo što rad koji opisuje put do nečega nije isto što i mašina koja je već stigla tamo.
To je razlika između mape i puta.
I tu je možda najpoštenije stati na trenutak.
Jer vrlo lako čovek pročita sve ovo i pomisli da su Kinezi napravili mašinu koja će sutra sama da napiše bolju verziju sebe.
Nisu.
Niti postoje javni dokazi za tako jaku tvrdnju.
Ali delovi mehanizma postoje.
A onda sa druge strane imamo američke i šire severnoameričke istraživače, kao i kompanije povezane sa tim ekosistemom, gde se dosta radi baš na drugom delu priče.
Darwin Gödel Machine je dobar primer.
Ovde agent ima svoj kod. Može da ga pročita, promeni, napravi novu verziju i testira je. Ako nova verzija radi bolje, ostaje. Iz nje se dalje prave nove verzije. Rad potpisuju istraživači sa University of British Columbia, Vector Institute i Sakana AI, a objavljen je kao ICLR 2026 rad.
Možeš da pogledaš sistem i kažeš: ovaj je promenio svoj kod i iz te promene dobio boljeg potomka.
Samo opet postoji jedna važna stvar.
Nije promenio svoju osnovnu neuronsku arhitekturu.
Promenio je kod agenta, alate, memoriju i način rada. Osnovni foundation modeli ostali su zamrznuti, a sami autori eksplicitno navode da u radu nisu pokazali automatsko treniranje novog foundation modela. To ostavljaju za budući rad.
Drugim rečima, samopoboljšava se sistem oko modela.
A to nije isto što i model koji menja sopstvene milijarde težina i zatim trenira naslednika.
Meta sa HyperAgents ide na sličan problem iz drugog ugla. Meta-agent može da menja agenta koji rešava zadatak, ali i deo programa koji predstavlja njega samog. Još važnije, sam mehanizam kojim meta-agent pravi buduće izmene takođe može da bude predmet izmene. Autori baš naglašavaju da sposobnost rešavanja zadatka nije automatski isto što i sposobnost poboljšavanja sopstvenog procesa poboljšavanja.
Ako si postao bolji programer, ne znači automatski da si postao bolji u tome da postaneš još bolji programer.
To zvuči kao filozofiranje dok ne sedneš da napraviš sistem koji to stvarno mora da radi.
Onda više nije filozofija.
Onda je problem.
Google je sa AlphaEvolve pokazao možda najvažniji praktični deo cele priče. Ne zato što sistem zvuči najviše kao naučna fantastika, nego zato što ima nešto što je svakom ovakvom sistemu potrebno: način da proveri rezultat bez čoveka koji sedi sa strane i kaže „ovo mi deluje bolje“. AlphaEvolve koristi Gemini modele za predlaganje izmena programa, zatim izvršava te programe i koristi rezultate evaluacije za dalje mutiranje i izbor kandidata.
To je evolucija programa u prilično bukvalnom smislu.
Tu nema mnogo filozofije. Ako algoritam radi isti posao za kraće vreme, bolji je. Ako daje bolji rezultat, bolji je.
Google je naveo da je AlphaEvolve pronalazio poboljšanja u algoritmima i računarskoj infrastrukturi, uključujući delove procesa treniranja Gemini modela. U jednom slučaju određeni kernel ubrzan je za 23 odsto, što je smanjilo vreme Gemini treninga za oko jedan odsto. Za FlashAttention je prijavljeno do 32,5 odsto ubrzanja.
Tu već počinje povratna sprega koja ima fizički smisao:
bolji algoritam, manje vremena, više eksperimenata, više eksperimenata, bolji algoritam.
Ne mora niko da priča o svesti mašine.
Dovoljno je da račun prestane da bude isti.
Sakana AI je otišao još šire. Njihov AI Scientist pokušava da automatizuje ceo istraživački postupak, od stvaranja ideje i pisanja koda, preko izvršavanja eksperimenata i analize rezultata, do pisanja rada i automatske recenzije. Sistem je predstavljen 2024. godine, a kasniji radovi Sakane nastavljaju tu liniju automatizovanog istraživanja.
https://sakana.ai/ai-scientist/
A 2026. su pokrenuli i Recursive Self-Improvement Lab, baš sa idejom da AI ne bude samo alat kojim ljudi prave sledeći AI nego deo samog procesa kojim se taj razvoj ubrzava. U njihovom sopstvenom opisu RSI Lab cilja na sisteme koji mogu da pišu, proveravaju i mere izmene sopstvenih osnovnih arhitektura i da povežu automatizovano istraživanje sa sopstvenim razvojem.
OpenAI takođe ima poseban Recursive Self-Improvement tim. Javni opis tog tima govori o automatizaciji stvarnih istraživačkih postupaka, petljama sa povratnim informacijama, proceni istraživačkog rasuđivanja, stvaranju i proveri hipoteza i dugotrajnim eksperimentima.
Znači, ovo nije izmišljena tema koju su ljudi pokupili iz nekog naučnofantastičnog romana.
Radi se na tome.
Ozbiljno se radi.
Samo još nismo stigli do one poslednje, najnezgodnije verzije priče.
Jer sve ovo vreme prećutkujemo jednu stvar.
Kako znaš da je nova verzija bolja?
Ako napraviš novi program, testiraš ga.
Ako napraviš novi model, proceniš ga.
Ako napraviš novi način treniranja, moraš da ga treniraš.
Ako napraviš novi algoritam, moraš da ga pokreneš.
Nema prečice.
I tu je možda cela stvar sa RSI-jem mnogo manje glamurozna nego što izgleda na prvu.
AI → ideja → eksperiment → rezultat → informacija → novi AI
Bez rezultata nema informacije.
Bez informacije nema izbora.
Bez izbora nema sistematskog napretka.
Recimo da imaš verziju A i verziju B.
A dobije 70.
B dobije 75.
Lepo.
Uzimaš B.
Ali šta ako AI sam napravi test?
A dobije 70.
B dobije 9000.
B je genije.
Samo što je prethodno promenio kontrolni.
Tu više ne znaš da li je sistem postao bolji ili je samo naučio da vara profesora.
Zato je evaluator, odnosno način provere rezultata, toliko važan.
Kod AlphaEvolve-a program mora stvarno da radi i prolazi proveru funkcionalnosti. Kod DGM-a agenti se ocenjuju na coding benchmarkovima, a kod RSIR-a generisane sekvence prolaze fidelity kontrolu pre nego što uđu u sledeći krug treniranja.
To je ona stvar koja sistem drži vezanim za stvarnost.
I sad već moramo malo da pogledamo ispod haube.
Računanje nije besplatno.
Ako AI napravi jedan bolji algoritam, mora da ga izvrši.
Ako napravi deset kandidata, mora da izvrši deset.
Ako napravi milion, neko mora da obezbedi računanje za milion.
GPU nije vila koja sedi u serveru i iz čiste ljubavi prema nauci vrti matrice.
Troši struju.
Greje se.
Traži memoriju, propusnost i komunikaciju sa drugim procesorima.
Sve to košta.
Čak i fundamentalna fizika ima šta da kaže o tome. Landauerov princip daje donju granicu energije potrebne za nepovratno brisanje jednog bita:
E ≥ kT ln 2
Za običnog čoveka sasvim je dovoljno znati da je to granica koja povezuje obradu informacije sa fizičkom potrošnjom energije. Savremeni računari su još veoma daleko od te granice, što se vidi iz procena koje stvarnu potrošnju računarskih kola stavljaju mnogo iznad kT ln 2 po bitu.
Današnji računari su veoma daleko od te granice. Ali poenta nije u tome da ćemo sutra računati po Landaueru.
Poenta je mnogo prostija.
Informacija se fizički obrađuje.
Računanje ima cenu.
I zato postoji ogromna razlika između „AI može da napravi bolji algoritam“ i „AI može da napravi toliko bolji algoritam da će mu sledeća generacija biti jeftinija za pravljenje“.
Ovo drugo je ono što bi stvarno moglo da napravi ozbiljnu povratnu spregu.
Ako prva generacija napravi bolji algoritam, a druga generacija zbog toga zahteva još više računanja nego pre, dobili smo bolji algoritam i veći račun.
Nije baš Skynet.
Više je firma koja je kupila još jedan server jer je prethodni projekat optimizovala tako da sada može da radi dvadeset četiri sata umesto dvanaest.
Prava fora bi bila:
bolji AI napravi bolji algoritam,
taj algoritam smanji cenu treniranja,
zbog toga možeš da pokreneš više eksperimenata,
više eksperimenata pronađe još bolji algoritam,
koji dodatno smanji cenu sledećeg treniranja.
Tu već imaš spiralu.
Matematički, možeš da je svedeš na jednu prilično prizemnu stvar:
dobitak > cena
Ako je dobitak veći od cene svakog sledećeg kruga, sistem ima razlog da nastavi.
Ako nije, nema eksplozije.
Imaš automatizovano istraživanje i razvoj koji postaje sve skuplji.
A onda dolazi još jedna nezgodna stvar.
Pretraga.
Jer šta sve možeš da menjaš?
Arhitekturu.
Način treniranja.
Stopu učenja.
Funkciju greške.
Skup podataka.
Memoriju.
Alate.
Kod.
Način usmeravanja modela.
Metod kojim biraš sledeći eksperiment.
Kombinacija ima koliko hoćeš.
Ako za svaku mogućnost moraš da istreniraš veliki model od početka, vrlo brzo si potrošio sve što imaš.
Zato sistem mora da zna šta uopšte vredi probati.
DGM, recimo, ne pokušava sve. Pravi stablo kandidata, testira određene grane, čuva ono što radi i od toga pravi sledeće izmene. Sam rad baš naglašava archive, odnosno skup ranijih verzija, kao bitan deo otvorene pretrage kroz prostor mogućih poboljšanja.
To je mnogo bliže genetskom algoritmu nego nekoj mističnoj sposobnosti da mašina „razmišlja o sebi“.
I tu se lepo vidi da RSI zapravo nije jedna stvar.
Treba ti pretraga.
Treba ti optimizacija.
Treba ti memorija.
Treba ti eksperiment.
Treba ti računanje.
Treba ti dobar način izbora.
I pre svega treba ti provera koja neće da te laže.
Jer postoji još jedan način da AI napravi „bolju“ verziju sebe.
Da napravi sopstvene podatke.
Pa trenira na njima.
Pa sledeća verzija napravi nove.
Pa sledeća trenira na njima.
Na papiru izgleda sjajno.
Model A napravi podatke A.
Model B nauči iz njih.
Model B napravi podatke B.
Model C nauči iz njih.
I tako dalje.
Samo što se greška lepo prenosi zajedno sa znanjem.
Ako prvi model napravi neku glupost, drugi može da je nauči. Treći može da je utvrdi. Četvrti može da bude potpuno uveren da je to činjenica jer je tri generacije njegovih predaka ponavljaju.
Kineski RSIR je zanimljiv baš zbog toga što uvodi kontrolu vernosti. Autori izričito navode problem nekontrolisane zatvorene petlje i potrebu da se generisani primeri filtriraju pre narednog treniranja.
Samopoboljšavanje lako može da postane samopokvarivanje.
I to je možda najzanimljivija granica cele priče.
Danas već imamo sisteme koji prave bolje podatke.
Imamo agente koji menjaju sopstveni kod.
Imamo sisteme koji evoluiraju programe.
Imamo modele koji učestvuju u naučnom istraživanju.
Imamo zatvorene petlje.
Imamo istraživačke grupe koje otvoreno rade na rekurzivnom samopoboljšavanju.
Ono što još nemamo javno pokazano u jakom smislu jeste sistem koji uzme ceo taj lanac i sam ga vodi od početka do kraja.
Ne samo da napravi bolji odgovor.
Ne samo da popravi kod.
Ne samo da napravi bolje podatke.
Nego da otkrije bolji način učenja, promeni sopstveni postupak učenja, istrenira novu verziju, pa ta verzija otkrije još bolji način traženja poboljšanja i nastavi dalje.
Tu više ne pričamo samo o boljem programu.
Tu sistem poboljšava mašinu kojom traži poboljšanja.
To je mnogo viša lestvica.
Zanimljivo je što su različiti delovi te priče već razbacani po svetu.
Kina radi na samostalnom pravljenju podataka, samoevoluciji agenata, rekurzivnom treniranju i samom pojmu meta-poboljšavanja. RSIR je USTC/Huawei primer rekurzivne petlje, AgentEvolver je projekat Alibaba Tongyi Lab-a, a rad The Last AI Built by Humans upravo pokušava da formalno opiše put od autonomnog izvršavanja poboljšanja do rekurzivnog meta-poboljšavanja.
Kad sve pogledaš sa strane, počinješ da vidiš nešto što više liči na sastavljanje mašine nego na jedan veliki pronalazak.
Komad ovde.
Komad onde.
Neko rešava stvaranje podataka.
Neko pretragu.
Neko promenu koda.
Neko proveru.
Neko automatizaciju istraživanja.
A onda ostaje ono dosadno pitanje koje u ovakvim pričama obično niko ne voli.
Kako sve to spojiti, a da sistem ne počne da optimizuje pogrešnu stvar?
Jer nije dovoljno da nova verzija bude bolja.
Moraš znati po čemu je bolja.
Nije dovoljno da napravi više podataka.
Moraš znati da nisu lošiji.
Nije dovoljno da napravi novu arhitekturu.
Moraš imati računanje da je proveriš.
Nije dovoljno da promeni algoritam učenja.
Moraš da sačekaš da se nova verzija stvarno istrenira.
I nije dovoljno da nova verzija bude pametnija.
Za pravi RSI mora da bude bolja i u pravljenju sledeće verzije.
E tu se priča vraća na ono prvo pitanje.
Ne:
Može li AI da poboljša sam sebe?
To već može, u raznim ograničenim oblicima.
Pravo pitanje je:
Može li AI da poboljšava način na koji poboljšava sebe brže nego što rastu troškovi tog procesa?
Ako može, dobijaš nešto što liči na ozbiljnu rekurzivnu spiralu.
Ako ne može, dobijaš automatizovanu laboratoriju.
I jedno i drugo je zanimljivo.
Samo nije isto.
Zato mi je zapravo zanimljivija priča o serverima, memoriji, evaluatorima, algoritmima i računu za struju nego priča o mašini koja će „postati svesna sebe“.
Za početak, ako sistem napravi bolji algoritam, mora da ga izvrši.
Ako napravi bolji model, mora da ga istrenira.
Ako napravi bolju arhitekturu, mora da plati njeno testiranje.
Ako napravi sopstvene podatke, mora da proveri šta je zapravo napravio.
Ako promeni kriterijum kojim meri uspeh, više ne znaš da li je postao bolji ili je samo promenio pravila igre.
A ako svaka nova generacija potroši više nego što prethodna uštedi, nema nikakve eksplozije.
Samo veći račun za struju.
I tu se, izgleda, naučna fantastika za sada najčešće sudara sa server-sobom.
Ne sa nekim velikim filozofskim zidom.
Nego sa vrlo običnim pitanjem:
koliko traje trening i ko plaća struju?
Jer računar može da menja svoj kod.
Može da menja model.
Može da menja način na koji uči.
Možda će jednog dana menjati i način na koji traži sledeću promenu.
Ali ne može da promeni zakone po kojima taj kod mora da radi.